Источник: Difference Between Process And Thread in Linux
Автор: Sarath Pillai · 23 апреля 2018
Мы постоянно слышим, как люди используют два термина. Один — «процесс», другой — «поток». Что из них процесс, а что поток, и что различает эти два понятия — часто сбивает с толку многих людей.
В этой статье мы попробуем раскрыть каждое из этих понятий в контексте операционной системы Linux и понять их основные различия.
Начнём сначала с процессов, а затем перейдём к потокам. Самое распространённое определение процесса, которое можно найти: «Это экземпляр программы, находящийся в состоянии выполнения». Но что это вообще значит?
В некотором роде процесс можно сравнить с объектами в ООП (объектно-ориентированном программировании). В ООП объект также определяется как экземпляр класса. Каждый объект получает собственные значения и характеристики, но объект создаётся, глядя на класс как на чертёж. Из одного класса можно создать множество объектов.
Связанное: Basics of Object Oriented Programming
Аналогично, если в Linux у вас есть программа текстового редактора, например «vi», пользователь userA может открыть текстовый редактор (один экземпляр программы «vi»), пользователь userB тоже может открыть тот же текстовый редактор (другой экземпляр программы «vi»). Давайте попробуем сделать это в Linux.
Приведённые ниже команды выполняются в двух отдельных терминалах. Это откроет текстовый редактор vi и позволит создать новый текстовый файл.
user1@localhost:~$ vi testfile1user2@localhost:~$ vi testfile2Теперь используем другой терминал, чтобы выяснить, сколько процессов vi запущено в системе.
root@localhost:~# ps aux|grep vi
user2     6167  0.0  0.8  52616  8464 pts/1    S+   11:55   0:00 vi testfile2
user1     6168  0.0  0.8  52616  8448 pts/0    S+   11:55   0:00 vi testfile1
Из приведённого выше вывода ясно видно, что каждый экземпляр нашей программы «vi» создал собственный процесс. Именно отсюда популярное определение «Процесс — это экземпляр программы, находящийся в состоянии выполнения». Если сравнить это с ООП, упомянутым ранее, программа похожа на класс, а процесс — на объекты (ну, в некоторых отношениях… не на 100 процентов).
Процессы по своей природе полностью динамичны. Они непрерывно меняются по мере того, как CPU выполняет инструкции. Ядро Linux спроектировано так, что каждый процесс имеет собственные права и разрешения. Проблема в одном процессе не может повлиять на другие процессы, запущенные в системе. Это потому, что у каждого процесса своё обособленное адресное пространство.
Каждый процесс в системе идентифицируется числом, называемым PID (число во второй колонке показанного ранее вывода наших процессов «vi» — это номер PID. Если заметили, у обоих процессов свои номера PID). Это число выделяется ядром и освобождается для переиспользования при выходе процесса. Даже если вы запустите команду, которая завершается за секунду, она всё равно создаст процесс с номером PID. Если вам интересны дополнительные детали администрирования процессов в Linux, рекомендую прочитать статью ниже.
Читать: Administering Linux Processes
Чтобы сделать в Linux что-то полезное, вам нужны системные вызовы. Без системных вызовов вы не сможете сделать большую часть работы (прочитать файл, записать файл, открыть порт).
Системные вызовы — это не что иное, как способ взаимодействия с операционной системой, чтобы она могла делать вещи, на которые у вас нет прямого разрешения. Даже для создания процесса вам нужно попросить операционную систему сделать это за вас (когда я говорю «операционная система», я имею в виду ядро). Помните, мы упоминали, что каждый процесс (то есть экземпляр программы :) — теперь вы знаете определение) имеет уникальное число, называемое PID? Это число тоже выделяется ядром. Так что даже это — системный вызов. Многие программы будут читать и писать разные файлы — всё это достигается системными вызовами.
Если хотите узнать о системных вызовах чуть больше, рекомендую прочитать ниже.
Читать: Understanding System Calls in Linux
Чтобы облегчить жизнь программистам, есть функции библиотеки C почти для всего (предоставляемые GNU C library). Как я упоминал, вам нужно использовать системные вызовы почти для каждой операции в системе (чтение, запись, создание процесса и т.д.). Как программисту, вам не нужно сильно беспокоиться о том, какой системный вызов использовать для какой операции и как запустить конкретный системный вызов. Вы можете использовать функции библиотеки C с подходящими параметрами, которые, в свою очередь, запустят системный вызов за вас. Например, мне не нужно знать системный вызов для записи чего-то в файл (я использую библиотечную функцию с именем «write» — да, в большинстве случаев имя системного вызова и библиотечной функции выглядят похоже).
Каждый процесс в Linux создаётся родительским процессом с помощью библиотечной функции/подпрограммы под названием fork (есть системный вызов с тем же именем, что и функция «fork»). Должен сказать, что всё, кроме INIT/systemd (самого первого процесса с PID 1 в Linux), создаётся методом fork.
Есть системный вызов с именем fork(). Соответствующая библиотечная функция также называется fork. Традиционно fork() — это системный вызов, создающий новые процессы. Но в наши дни системный вызов fork() фактически заменён чем-то другим (хотя сам системный вызов присутствует, он используется редко. Он всё ещё доступен для обратной совместимости.)
Вместо fork() системный вызов, используемый во всех свежих системах для создания процессов, называется clone(). clone() очень похож на fork(), но имеет больше возможностей и универсален по природе. Поскольку clone() может делать то, что делал fork(), плюс некоторые дополнительные вещи, даже стандартная функция библиотеки C с именем fork() вызывает clone().
Суть вот в чём… clone() заменяет fork() во всех современных системах. Даже если вы используете функцию fork из библиотеки C, функция, в свою очередь, будет использовать clone().
Прежде чем идти дальше, главное, что нужно понять: нам нужна структура для процессов. Представим, что нам нужно хранить данные о сотрудниках компании. Простейший метод — создать переменные и присвоить им значения. Например, можно иметь переменные вроде empname1 = "sam", empage1 = 30, emplocation1 = "california" и т.д. Это станет messy по мере роста. Представьте 100 сотрудников (сколько переменных нам понадобится, и все — с прикреплёнными номерами. Это было бы забавно).
Лучший подход — создать структуру с именем employee с несколькими характеристиками вроде имени, возраста, местоположения и т.д. Когда нужно добавить сотрудника, мы просто используем структуру employee.
Теперь вы знаете, что и для процессов должна быть какая-то структура (потому что в системе будут работать сотни процессов). Каждый процесс в Linux создаётся с использованием структуры данных в C под названием task_struct.
Не путайтесь с термином «task» здесь. С точки зрения ядра задача — это не что иное, как процесс. Термины «task» и «process» — одно и то же.
Ядро (операционная система) держит все данные о процессах, запущенных в системе, в виде списка (называемого списком задач — task list… на самом деле это циклический связный список). Вы можете теперь догадаться, что за элементы в этом списке. Элементы — это структуры task_struct, описывающие каждый процесс.
Так какие же детали хранит task_struct о процессе? Она хранит много информации о процессе. Некоторые из них ниже. Кстати, теперь, когда мы знаем, что для каждого процесса есть нечто под названием task_struct, мы можем определить процесс так:
Процесс — это не что иное, как экземпляр структуры данных task_struct, которая описывает процесс и все его детали.
| ПОЛЕ В СТРУКТУРЕ ДАННЫХ TASK_STRUCT | ОПИСАНИЕ |
|---|---|
| state | Это легко угадать, когда речь о процессах. Процесс может быть в разных состояниях: прерываемое (interruptible), непрерываемое (uninterruptible), зомби (zombie), остановлен (stopped) и т.д. |
| ptrace | Относится к отладке процесса. Трассировке системных вызовов, выполняемых процессом. |
| static_prio | Значение nice для указания приоритета процесса |
| cpus_allowed | Программист может указать ядро CPU, где он хочет, чтобы процесс выполнялся — или ему разрешено выполняться — здесь устанавливается привязка к CPU (cpu affinity) |
| ptrace_children | Дочерний процесс под ним, который трассируется (фактически это снова указатель на другую структуру) |
| ptrace_list | Другие родительские процессы, которые трассируют этот процесс (ещё одна структура) |
| mm | Как мы знаем, поля task_struct могут указывать на другие структуры (похожие на task_struct), это поле mm указывает на другую структуру под названием mm_struct. Это описание памяти конкретного процесса. По сути, физические страницы памяти и адресное пространство, выделенные процессу |
| exit_code, exit_signal | Эти поля используются для хранения сигналов и кодов выхода при завершении процесса. Это даст родительскому процессу знать, как умер потомок |
| pdeath_signal | Сигнал, который отправляется при смерти родителя |
| pid | идентификатор процесса |
| parent, children | Это снова другая структура, указывающая на родительский процесс и любых потомков этого процесса |
| utime,stime,cutime,cstime | пользовательское время, системное время, суммарное пользовательское время, проведённое процессом и его потомками, общее системное время, проведённое процессом и потомками |
| gid,uid,environment | идентификатор группы, идентификатор пользователя и переменные окружения, доступные процессу |
| files | информация об открытых файлах — снова другая структура |
| signals | обработчики, связанные с определёнными сигналами, сигналы, которые отложены, и т.д. |
| tgid | Идентификатор группы потоков (объясню к концу статьи) |
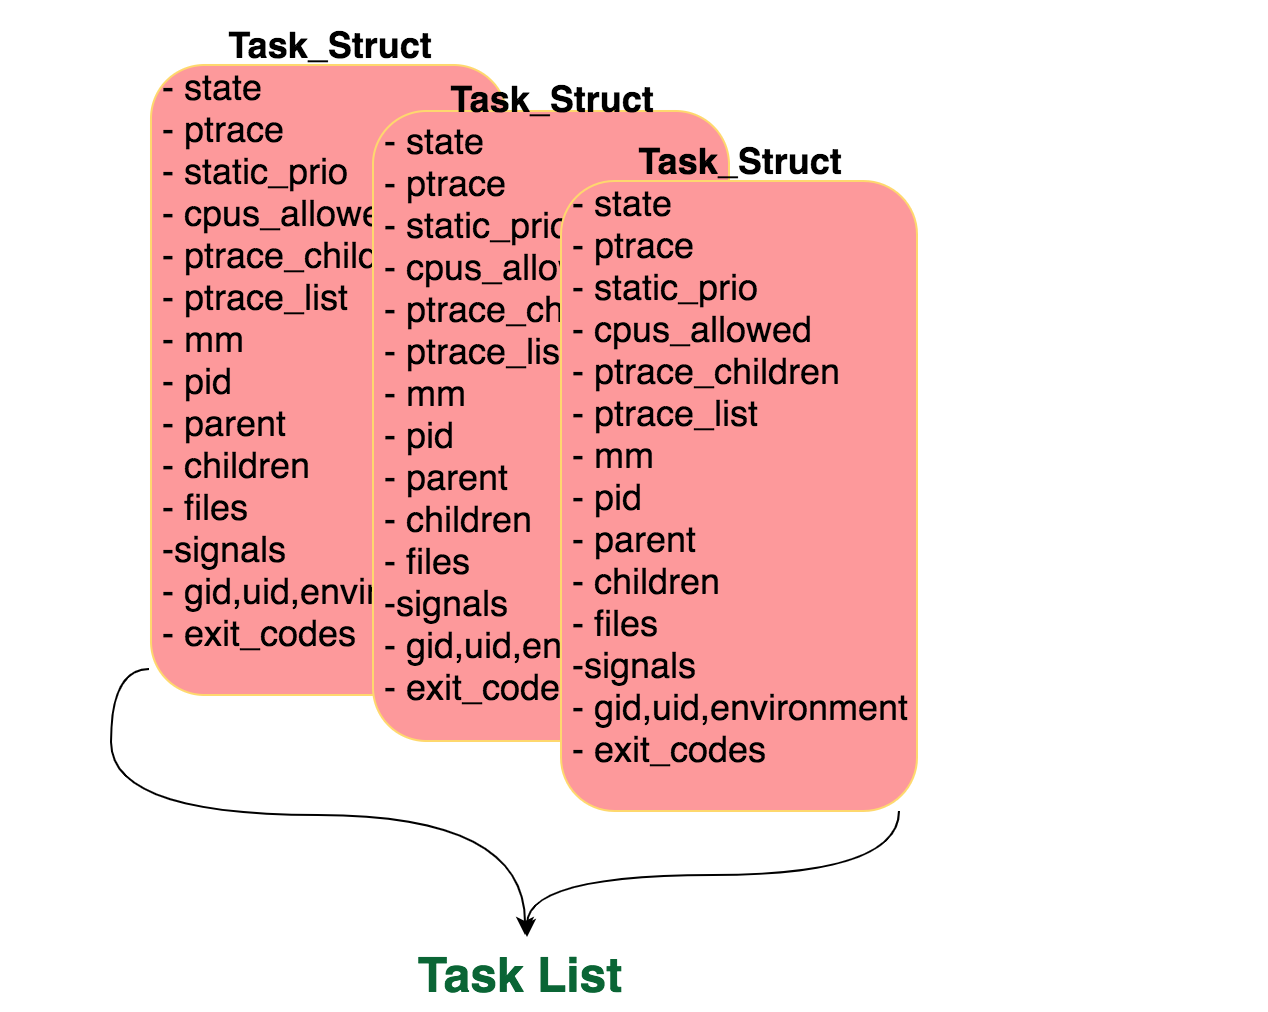
Создание процесса в Linux включает два системных вызова. Первый создаёт клон вызывающего процесса. Представим, что вы собираетесь выполнить команду «date» в Linux. Вызывающий процесс — конечно, bash shell. Первый системный вызов, который создаёт процесс как клон процесса shell, называется clone(). Независимо от того, какая библиотечная функция вызвана, будет вызван clone() для создания дочернего процесса. Когда дочерний процесс создан, нам нужно заменить исполняемый файл в этом процессе на бинарник команды date. Это достигается системным вызовом execve().
Вы можете практически увидеть это, выполнив команду ниже.
ubuntu@localhost:~$ strace -f -etrace=execve,clone bash -c '{ date; }'
execve("/bin/bash", ["bash", "-c", "{ date; }"], [/* 21 vars */]) = 0
clone(child_stack=0, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7f531bc639d0) = 19163
strace: Process 19163 attached
[pid 19163] execve("/bin/date", ["date"], [/* 21 vars */]) = 0
Wed Apr 25 08:25:49 UTC 2018
[pid 19163] +++ exited with 0 +++
--- SIGCHLD {si_signo=SIGCHLD, si_code=CLD_EXITED, si_pid=19163, si_uid=1000, si_status=0, si_utime=0, si_stime=0} ---
+++ exited with 0 +++
Дочерний процесс обычно — копия родителя. При этом различаться будут номер PID и PPID (идентификатор родительского процесса), который будет установлен в pid вызывающего (в нашем случае — идентификатор процесса bash). У потомка также будут новые отложенные сигналы (он не наследует отложенные сигналы от родителя. Просто представьте: если у родительского процесса уже было несколько сигналов, ожидающих выполнения, потомок не должен получить их при клонировании).
Системный вызов execve() заменяет дочерний процесс исполняемой программой (в нашем примере — командой date с абсолютным путём… смотрите вывод strace выше). Это заменит адресное пространство на новое для команды date. Скопированное адресное пространство для нашего нового процесса выбрасывается, как только происходит execve.
Помните о том, что каждый процесс в Linux находится внутри так называемого дерева. Люди называют это дерево деревом процессов (process tree). Вы можете увидеть его, выполнив команду pstree в Linux. У каждого процесса есть родитель и 0 или более потомков (и всё это начинается с самого главного INIT с pid 1).
Мы поняли из показанного выше вывода strace, что каждый потомок рождается клонированием родителя, а затем заменой бинарника для выполнения вызовом execve() (который выбросит скопированное адресное пространство).
Представим ситуацию, где нам не нужен execve(). Нам нужен только вызов fork(), который внутри использует clone() для создания нового дочернего процесса — точной копии родительского процесса.
Есть случаи, когда execve() не нужен. Например, представим, что вам нужно много рабочих процессов, чтобы делать что-то параллельно. Может быть, для приёма входящих TCP-соединений в вашем приложении?
В тех случаях вам действительно не нужен execve(). Потому что вы не собираетесь заменять исполняемый бинарник. Вам просто нужен ещё один процесс, чтобы делать работу параллельно. Хотя мы говорим, что дочерний процесс — копия родителя с тем же адресным пространством, он на самом деле не копирует адресное пространство. Оно копируется, только если потомок собирается делать операции записи (иначе зачем нам вообще копия, если над копией не производится модификаций?)
Копирование происходит, только когда потомок пытается что-то изменить. Так экономится время и ресурсы, необходимые для копирования адресного пространства. Это называется методом копирования при записи (Copy on Write). Обычно его называют COW.
Теперь вы знаете, почему Linux реализовал создание процессов комбинацией двух вызовов (clone и execv).
Если у нас есть приложение, которое может делать только одну вещь за раз — это действительно плохо. Не находите? Например, представьте веб-браузер, который позволяет просматривать только одну страницу за раз, или приложение, которое может читать ввод только с клавиатуры и ничего больше. Это немыслимо в сегодняшнем мире. Вот здесь и вступают потоки.
У процесса может быть несколько потоков. То есть потоки будут частью процесса (все потоки одного процесса будут разделять один PID).
Что ж, если вы хотите, чтобы несколько вещей происходили одновременно, этого можно достичь несколькими процессами. Зачем потоки? Это потому, что коммуникация между процессами не так проста, если смотреть с точки зрения приложения. Разделение данных между процессами (в Linux у вас есть pipes или сокеты и т.д., чтобы делиться между процессами) влечёт некоторые накладные расходы — и сравнительно медленно. Переключение контекста между потоками быстрее по сравнению с переключением между процессами.
Ядро постоянно переключается между задачами своевременным образом. Это для честного разделения CPU между всеми задачами (процессами) в системе. Переключение процесса влечёт чуть больше накладных расходов по сравнению с потоками. Это потому, что потоки всегда находятся в разделяемом адресном пространстве, так что меньше вещей нужно заменять, когда процессор меняет контекст выполнения с одного потока на другой.
Помните, мы узнали, что системный вызов fork() редко используется в наши дни, вместо него для создания процессов используется clone()? Тот же clone() используется для создания потоков в Linux. Да. Важны параметры, переданные системному вызову clone().
Если системный вызов clone имеет параметры ниже, он создаст нечто, похожее на поток, а не дочерний процесс.
clone(CLONE_VM | CLONE_FS | CLONE_FILES | CLONE_SIGHAND, 0);То, что вы видите как параметры функции clone выше, указывает, что нужно разделять при создании нового процесса/потока.
Собственно, приведённый выше системный вызов clone() создаст дочерний процесс, в котором адресное пространство (CLONE_VM), информация о файловой системе (CLONE_FS), открытые файлы (CLONE_FILES) и отложенные сигналы (CLONE_SIGHAND) будут разделяться. Вот почему я ранее упомянул, что системный вызов clone() универсален по природе. Вы можете разделять что угодно при создании нового процесса. Фактически вы можете создавать сущности, которые не являются ни процессами, ни даже потоками, из-за гибкой природы системного вызова clone в Linux.
POSIX (portable operating system interface) — это набор стандартов, регулирующих операционные системы (на базе unix). Нужен стандарт для совместимости. Есть стандарт для программного интерфейса, для shell и почти для всего в операционной системе. Аналогично есть стандарт и для потоков. Первоначальная реализация потоков в Linux не полностью соответствовала стандарту POSIX.
Было несколько серьёзных причин, почему первоначальная реализация потоков Linux не соответствовала POSIX. Одна основная причина — PID. Ранние реализации потоков имели разные номера PID (похоже на то, как процессы имели разные PID).
Чтобы исправить эти проблемы в реализации потоков, Red Hat начала проект под названием NPTL (Native Posix Thread Library), который позже был включён в ядро Linux (начиная с версии ядра 2.6). Библиотечная функция для создания потоков также была включена в GNU C library. Эта библиотечная функция называется pthread_create.
Хотя вы можете использовать системный вызов clone для создания потока, рекомендуется использовать pthread_create. Это по причинам переносимости (не обязательно, что вариант Unix будет иметь доступный системный вызов clone(). Однако библиотеку pthread_create всё ещё можно использовать, так как она возьмёт на себя низкоуровневый системный вызов и другие сложности).
У каждого потока есть task_struct, как у процессов. Так что ядро будет планировать их так же, как процессы (конечно, переключение между потоками супербыстрое по сравнению с переключением между процессами).
pthread_create внутри использует только системный вызов clone().
В man-страницах команды ps вы увидите примерно следующее для потоков.
To get info about threads:
    ps -eLf
    ps axms
Давайте попробуем. На одном из моих серверов запущен mongodb с несколькими потоками — это должен быть хороший пример. Смотрите ниже.
[root@localhost ~]# ps -efL |grep mongo
root      1470     1  1470  0   19 11:25 ?        00:00:11 /opt/mongodb-linux-x86_64-rhel62-3.0.4/bin/mongod --bind_ip 10.12.1.132 --dbpath /mnt/mongodb_data --fork --logpath /mnt/mongodb.log
root      1470     1  1471  0   19 11:25 ?        00:00:00 /opt/mongodb-linux-x86_64-rhel62-3.0.4/bin/mongod --bind_ip 10.12.1.132 --dbpath /mnt/mongodb_data --fork --logpath /mnt/mongodb.log
root      1470     1  1472  0   19 11:25 ?        00:00:00 /opt/mongodb-linux-x86_64-rhel62-3.0.4/bin/mongod --bind_ip 10.12.1.132 --dbpath /mnt/mongodb_data --fork --logpath /mnt/mongodb.log
root      1470     1  1473  0   19 11:25 ?        00:00:00 /opt/mongodb-linux-x86_64-rhel62-3.0.4/bin/mongod --bind_ip 10.12.1.132 --dbpath /mnt/mongodb_data --fork --logpath /mnt/mongodb.log
root      1470     1  1474  0   19 11:25 ?        00:00:06 /opt/mongodb-linux-x86_64-rhel62-3.0.4/bin/mongod --bind_ip 10.12.1.132 --dbpath /mnt/mongodb_data --fork --logpath /mnt/mongodb.log
Из вывода выше видно, что у всех этих процессов один и тот же номер PID (1470). Однако у них уникальные номера — идентификаторы потоков (1470, 1471, 1472, 1473, 1474).
В Linux эти идентификаторы потоков обозначаются LWP (имя колонки команды ps тоже LWP). LWP расшифровывается как Light Weight Process (лёгкий процесс).
Вообще-то… в Linux у каждой программы есть хотя бы один поток.
[root@localhost ~]# ps -efL
UID        PID  PPID   LWP  C NLWP STIME TTY          TIME CMD
root         1     0     1  0    1 09:19 ?        00:00:01 /sbin/init
root         2     0     2  0    1 09:19 ?        00:00:00 [kthreadd]
root         3     2     3  0    1 09:19 ?        00:00:00 [migration/0]
root         4     2     4  0    1 09:19 ?        00:00:00 [ksoftirqd/0]
root         5     2     5  0    1 09:19 ?        00:00:00 [stopper/0]
root         6     2     6  0    1 09:19 ?        00:00:00 [watchdog/0]
root         7     2     7  0    1 09:19 ?        00:00:00 [migration/1]
root         8     2     8  0    1 09:19 ?        00:00:00 [stopper/1]
root         9     2     9  0    1 09:19 ?        00:00:00 [ksoftirqd/1]
root        10     2    10  0    1 09:19 ?        00:00:00 [watchdog/1]
root        11     2    11  0    1 09:19 ?        00:00:00 [events/0]
root        12     2    12  0    1 09:19 ?        00:00:00 [events/1]
В однопоточных программах номер LWP и номер PID всегда одинаковы. Один поток — один процесс: так происходит в большинстве случаев.
TGID, или идентификатор группы потоков (thread group identifier), был введён для реализации совместимых с POSIX потоков в Linux. Идентификатор группы потоков — это обычно номер PID основного процесса.
Если у процесса 4 потока, у всех task_struct этих потоков TGID будет установлен в PID основного процесса (или, назовём его, первого потока).